Sin copias que se desfasen
La fuente es donde ya se escribe: repositorios, especificación de API y documentación existente, sincronizados solos y versionados.
IaGents Automatización empresarial con IA
Una sola fuente de conocimiento, versionada y con permisos, que consultan igual tu equipo y tus agentes.
Hablar de una implantación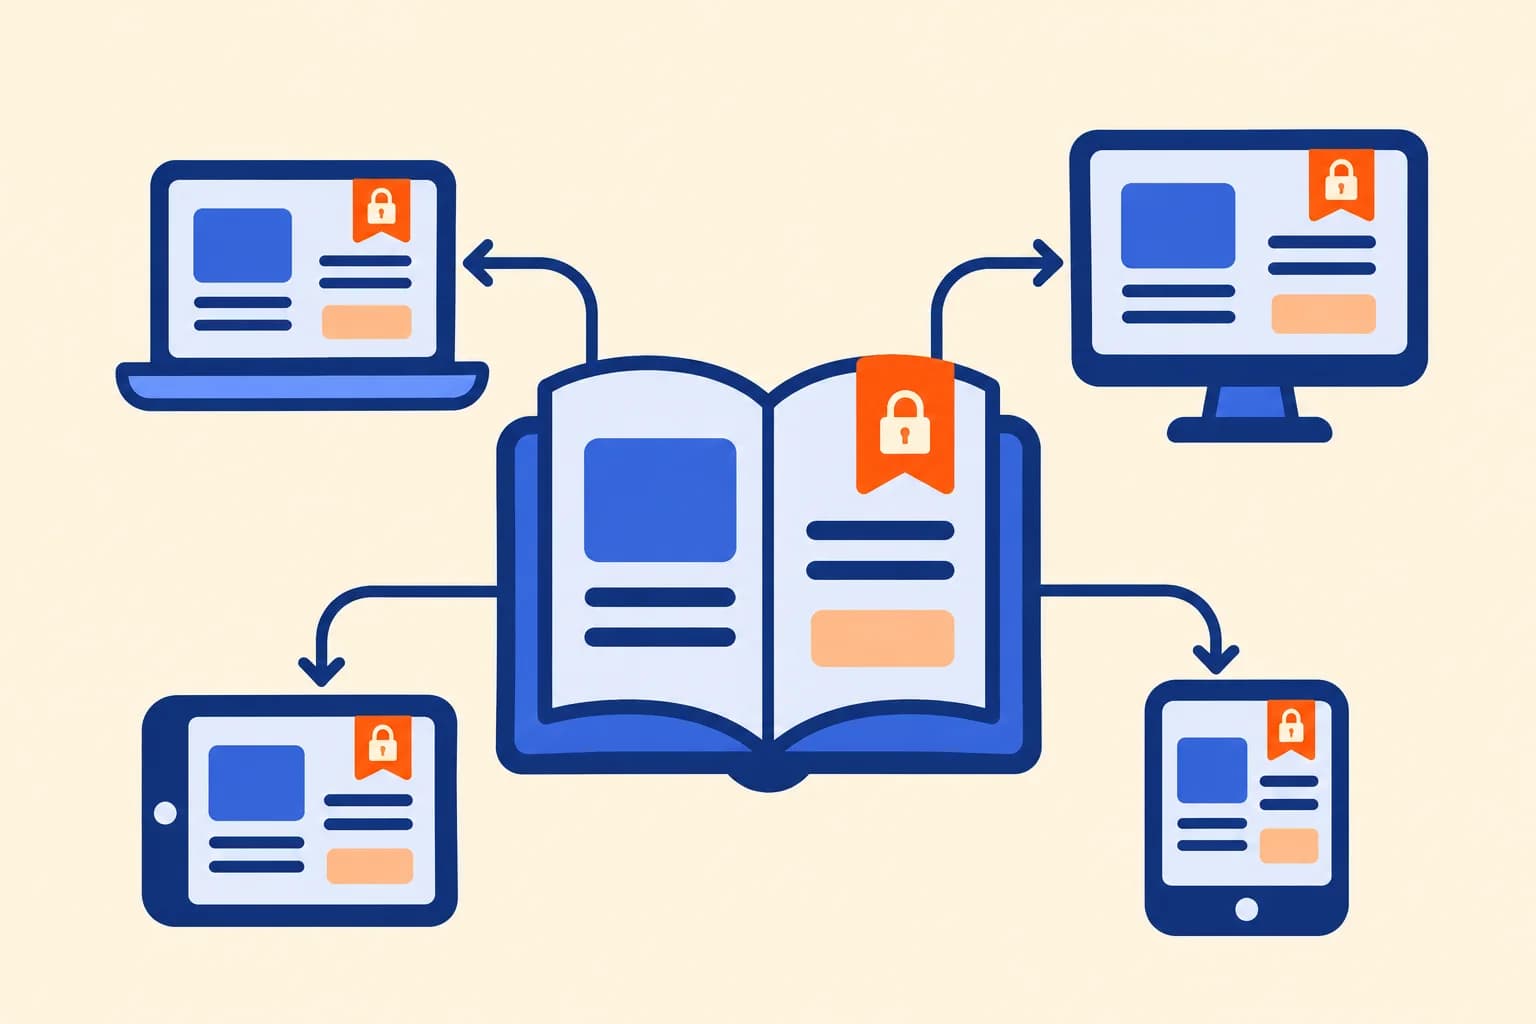
En este paso decide una persona
Personas y agentes consultan el mismo corpus. Lo que entra, lo aprueba una persona.
La documentación de una empresa vive en copias: una wiki que nadie actualiza, un fichero que alguien exportó hace meses, un hilo de chat donde se decidió algo. Cada copia se desfasa a su ritmo y los enlaces entre ellas se rompen. Cuando entran agentes de IA, el problema se multiplica: su memoria son ficheros sueltos, sin autor ni fecha, y lo que se acuerda hablando con ellos se pierde al cerrar la sesión.
El cerebro de empresa es una sola fuente versionada, sin copias, que personas y agentes consultan con los mismos permisos. Responde citando el documento y su versión, y cuando no tiene respaldo dice «no lo sé» en lugar de inventar.
Partimos de donde ya se escribe el conocimiento: la rama principal de tus repositorios (documentación, README y decisiones), la especificación de tus API y la documentación que ya exista. No pedimos a nadie que vuelva a escribir nada ni que mantenga una segunda copia.
Esas fuentes se sincronizan solas. Los espejos se indexan dos veces al día y la web de documentación se reconstruye cada diez minutos. Nunca publica un cambio que no esté fusionado, y si algo falla sigue sirviendo la última versión buena y avisa.
Antes de que ningún modelo vea nada, cada documento se trocea por títulos y se asigna a zonas de permiso por grupo. El filtro de permisos se aplica antes de ordenar los resultados, no después, y un documento que parece contener un secreto se descarta entero. La búsqueda combina texto en español y significado, y el modelo se ejecuta en la Unión Europea.
Los cambios de documentación entran por una revisión que aprueba una persona. Las memorias que guardan los agentes llevan autor, origen y versión, y sólo cuentan para el equipo cuando un administrador las aprueba. Ningún agente puede aprobar ni compartir.
Una web de documentación siempre al día y un chat que cita documento y versión en cada frase; sin respaldo, responde «no lo sé» y muestra los documentos más cercanos. Los agentes de código que ya usa tu equipo consultan el mismo corpus con la identidad de cada persona y ven exactamente sus zonas, ni una más. Los índices son derivados: se reconstruyen desde las fuentes en cualquier momento.
Definimos contigo qué fuentes son válidas, cómo se actualizan y quién puede consultar qué, y medimos la calidad de las respuestas con un conjunto de preguntas de referencia que crece con el uso.
Empresas con documentación repartida entre repositorios, wikis y exportaciones, donde el equipo ya pregunta a asistentes de IA y nadie sabe si la respuesta sale de la versión correcta. Especialmente útil cuando los agentes de código empiezan a tocar sistemas y necesitan las mismas reglas que las personas.
La capa de conocimiento está en marcha para un medio digital, construida en semanas. En su sistema anterior la documentación se desfasaba sin que nadie lo viera. Partimos de sus repositorios, su especificación de API y la documentación que ya existía; la sincronización, las zonas de permisos y el chat con cita quedaron en marcha sin que nadie reescribiera nada ni mantuviera una segunda copia.
Antes de abrirlo al equipo lo evaluamos con un conjunto de preguntas de referencia: la cita tiene que ser la correcta, el documento tiene que aparecer entre los primeros resultados, ninguna frase puede ir sin cita y las preguntas fuera de tema tienen que recibir un «no lo sé». Ese conjunto crece con el uso y es el mismo que medimos en cada implantación.
La fuente es donde ya se escribe: repositorios, especificación de API y documentación existente, sincronizados solos y versionados.
Cada persona y cada agente ven sus zonas, ni una más. El filtro se aplica antes de ordenar resultados y un documento sospechoso de contener secretos se descarta.
Cada frase cita documento y versión; sin respaldo, responde «no lo sé». Lo comprobamos con un conjunto de preguntas de referencia antes de abrirlo al equipo.