Una etiqueta puede representar a una persona, una organización, un lugar o un concepto. Si el sistema solo conserva una cadena de texto, aparecen homónimos, variantes y relaciones difíciles de gestionar. En nuestro trabajo de optimización de tags hemos creado una capa semántica sobre el catálogo existente: propone información útil, verifica referencias y permite revisar antes de publicar.
Empezar por la identidad
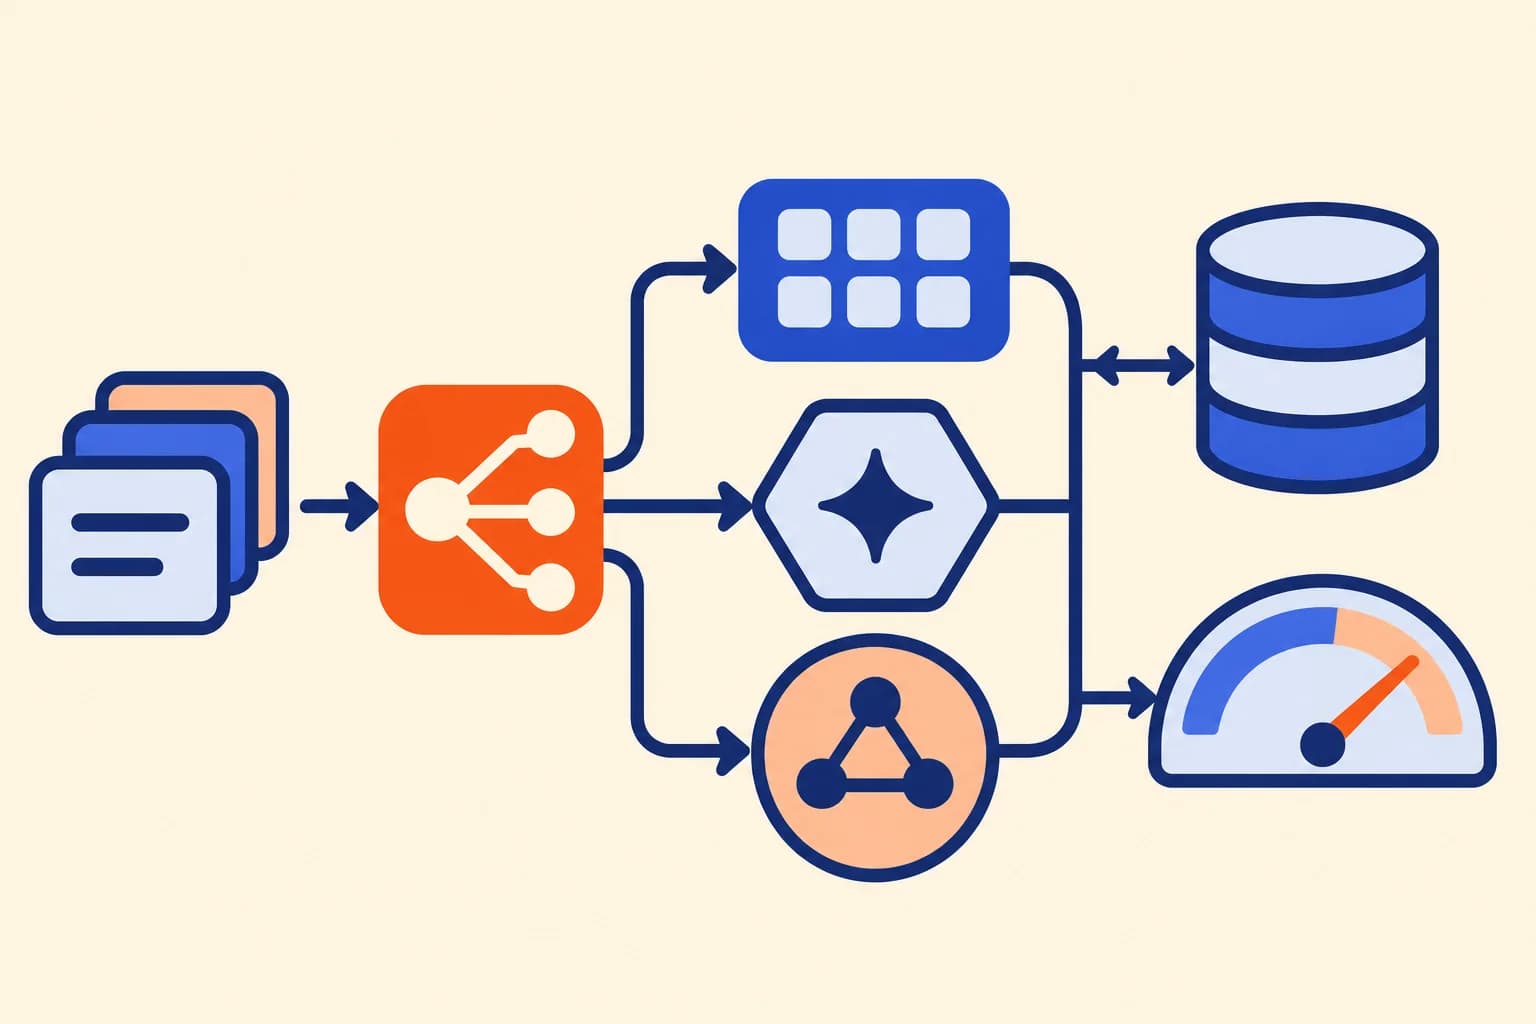
El pipeline busca candidatos en fuentes de entidades y selecciona entre opciones verificables. Después genera una ficha con tipo, desambiguación, alias, conceptos, relaciones y metadatos SEO. Los identificadores inventados se descartan. Cuando se trata de un concepto sin entidad externa, la ausencia de identificador no se interpreta automáticamente como mala calidad.
El catálogo se conserva como autoridad: enriquecer un tag existente y crear uno nuevo son operaciones distintas. El proyecto evita que la generación convierta una sugerencia en una ampliación silenciosa del CMS.
Revisar contenido y vigencia
Las propuestas pasan por validación de esquema y una bandeja de revisión. Un indicador de confianza prioriza casos, no publica. Sus señales incluyen verificación de entidad, reintentos y coherencia de la ficha; no es una probabilidad universal de acierto. Los responsables pueden editar las propuestas y comprobar las fuentes.
La temporalidad define cuándo reevaluar. Una persona puede cambiar de cargo; un evento tiene fechas; un concepto estable puede necesitar menos frecuencia. Las reglas y los precios se versionan. Si una reevaluación no cambia el contenido, evitamos crear trabajo de revisión vacío solo porque se haya actualizado una fecha técnica.
Proponer tags para contenidos nuevos
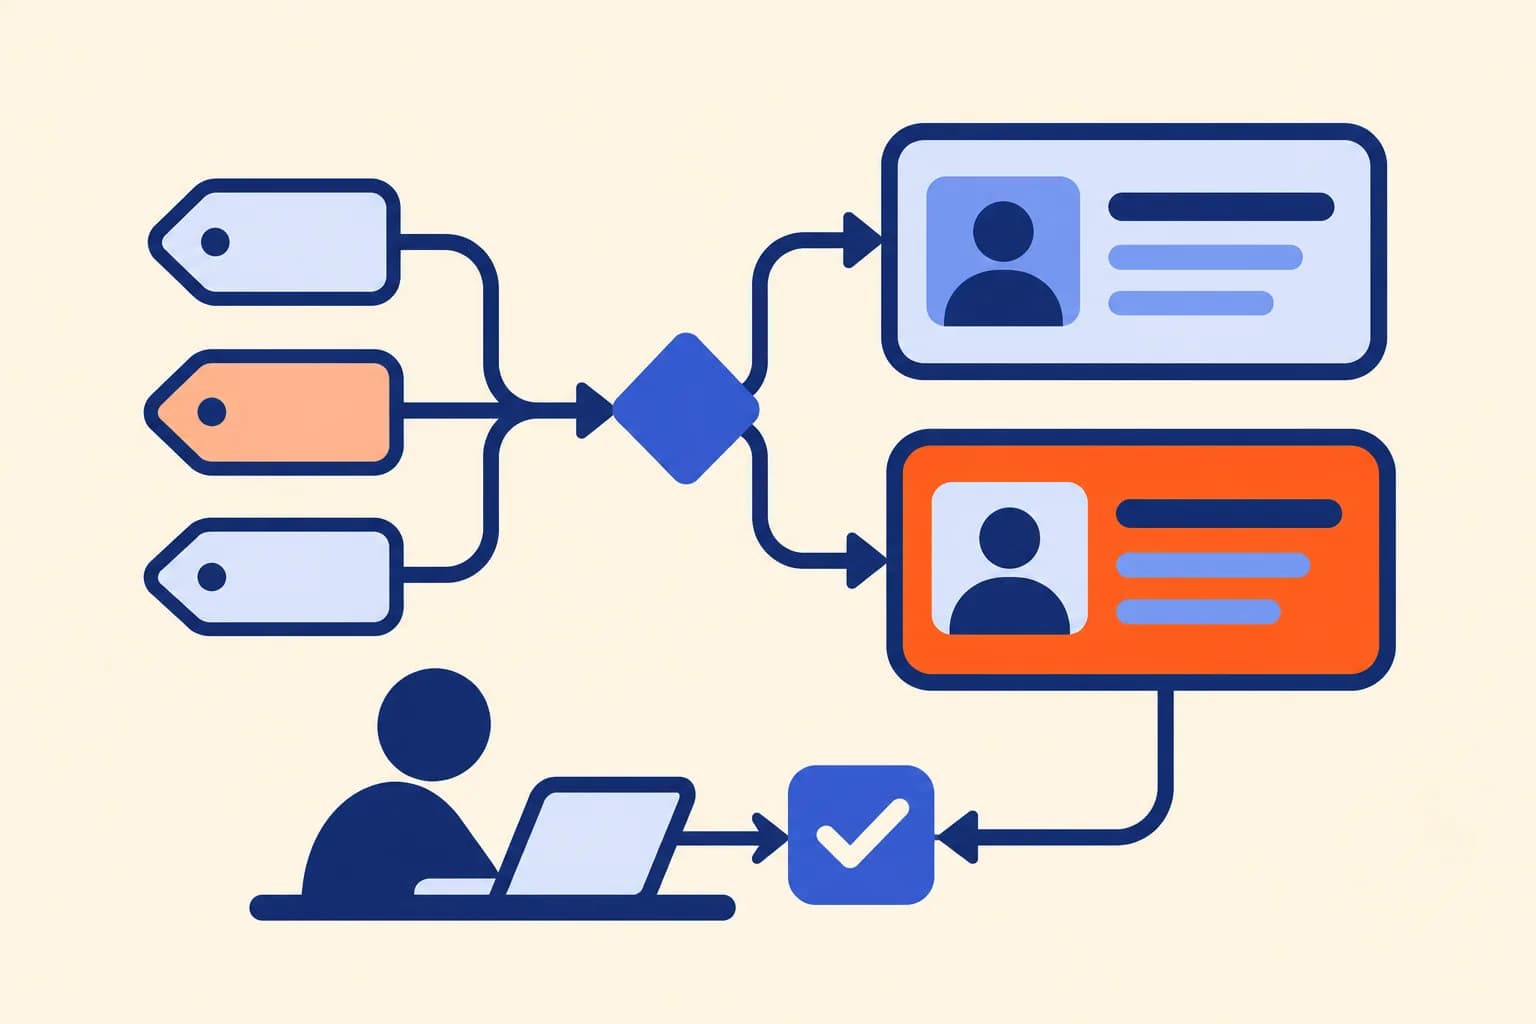
Otra capa usa el catálogo para recomendar etiquetas a piezas nuevas. Combina señales exactas, léxicas y semánticas, y conserva evidencias de cómo aparece cada candidato. La propuesta diferencia entidades centrales de menciones accesorias. Los umbrales se calibran con ejemplos revisados: una similitud de embedding no significa lo mismo para todo tipo de contenido.
Operar sin sorpresas
Los lotes registran consumo y costes. Las tareas programadas tienen flags de activación propios, bloqueos contra solapes y límites de reintento. Un sistema desplegado puede mantener la automatización apagada mientras se verifica; no confundimos disponer de un cron con estar publicando de forma autónoma.
La entrega incluye el catálogo enriquecido, criterios editoriales, revisión y trazabilidad. Puede conectar temas con búsqueda, navegación y segmentación contextual según el alcance acordado. El resultado que buscamos es una taxonomía explicable y mantenible, no una lista de palabras generadas sin un dueño.