Una migración de CMS empieza antes de escribir una sola redirección. El problema inicial es saber qué URLs existen, cuáles reciben tráfico, cuáles rastrean los bots y cuáles tienen valor editorial o comercial. Ninguna fuente responde por sí sola a todas esas preguntas.
Un inventario con procedencia
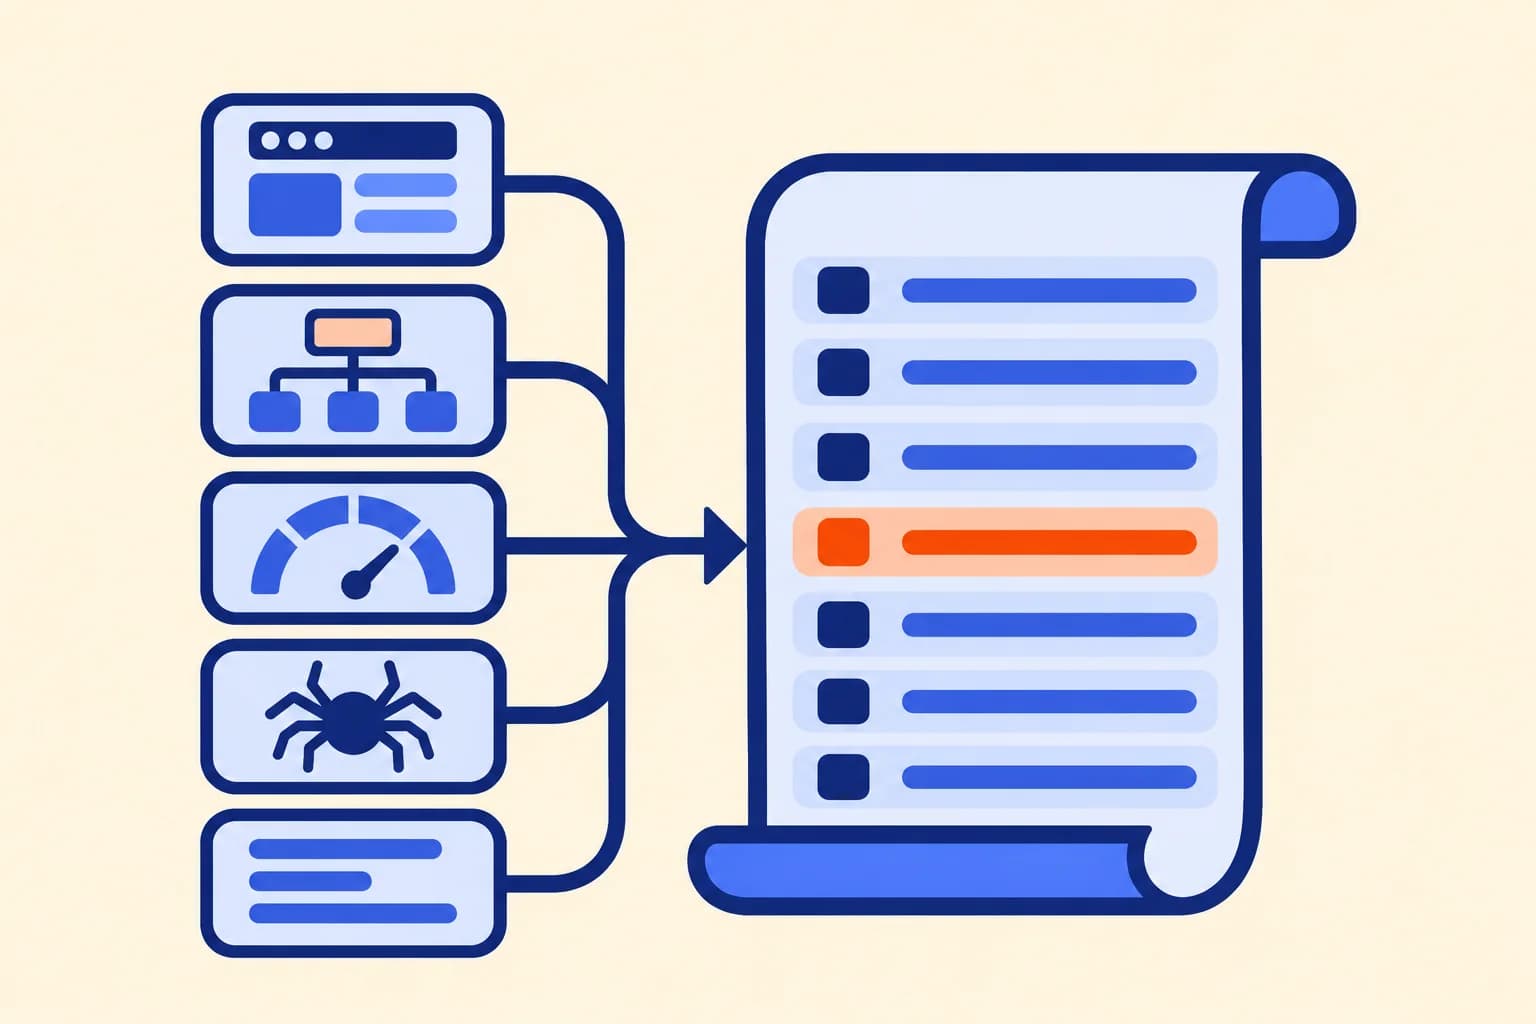
Unimos exportaciones del CMS, sitemaps, rastreos, Search Console y logs de CDN. Cada observación conserva su origen y fecha: un sitemap de hoy y un rastreo de hace meses describen momentos distintos. Normalizamos host, barras finales, parámetros y protocolos sin borrar la URL original. Así se pueden revisar discrepancias y evitar que una transformación silenciosa esconda páginas.
Estado y destino son campos distintos
Para cada URL anotamos respuesta HTTP, canonical, robots, tipo de plantilla, enlaces internos y señales de uso. Después definimos el destino propuesto en la nueva arquitectura. Una página que hoy devuelve 404 puede necesitar investigación; una URL que falta en el sitemap puede recibir tráfico o peticiones de Googlebot. Ausencia en una fuente no significa ausencia real.
Antes y después del corte
El plan debe tener pruebas de aceptación por plantilla y por cabecera: redirecciones, canonicals, hreflang, datos estructurados, sitemaps y páginas de negocio. Congelamos una línea base y repetimos las comprobaciones tras el lanzamiento. Los cambios se agrupan por patrón y severidad para que tecnología, SEO y redacción trabajen sobre una misma lista de incidencias.
La utilidad del inventario está en hacer visibles las decisiones: qué se conserva, qué se transforma, qué se retira y quién valida cada excepción.